N° 1 du jour
Moteur d'inférence open source de DeepSeek pour V4.1-Flash

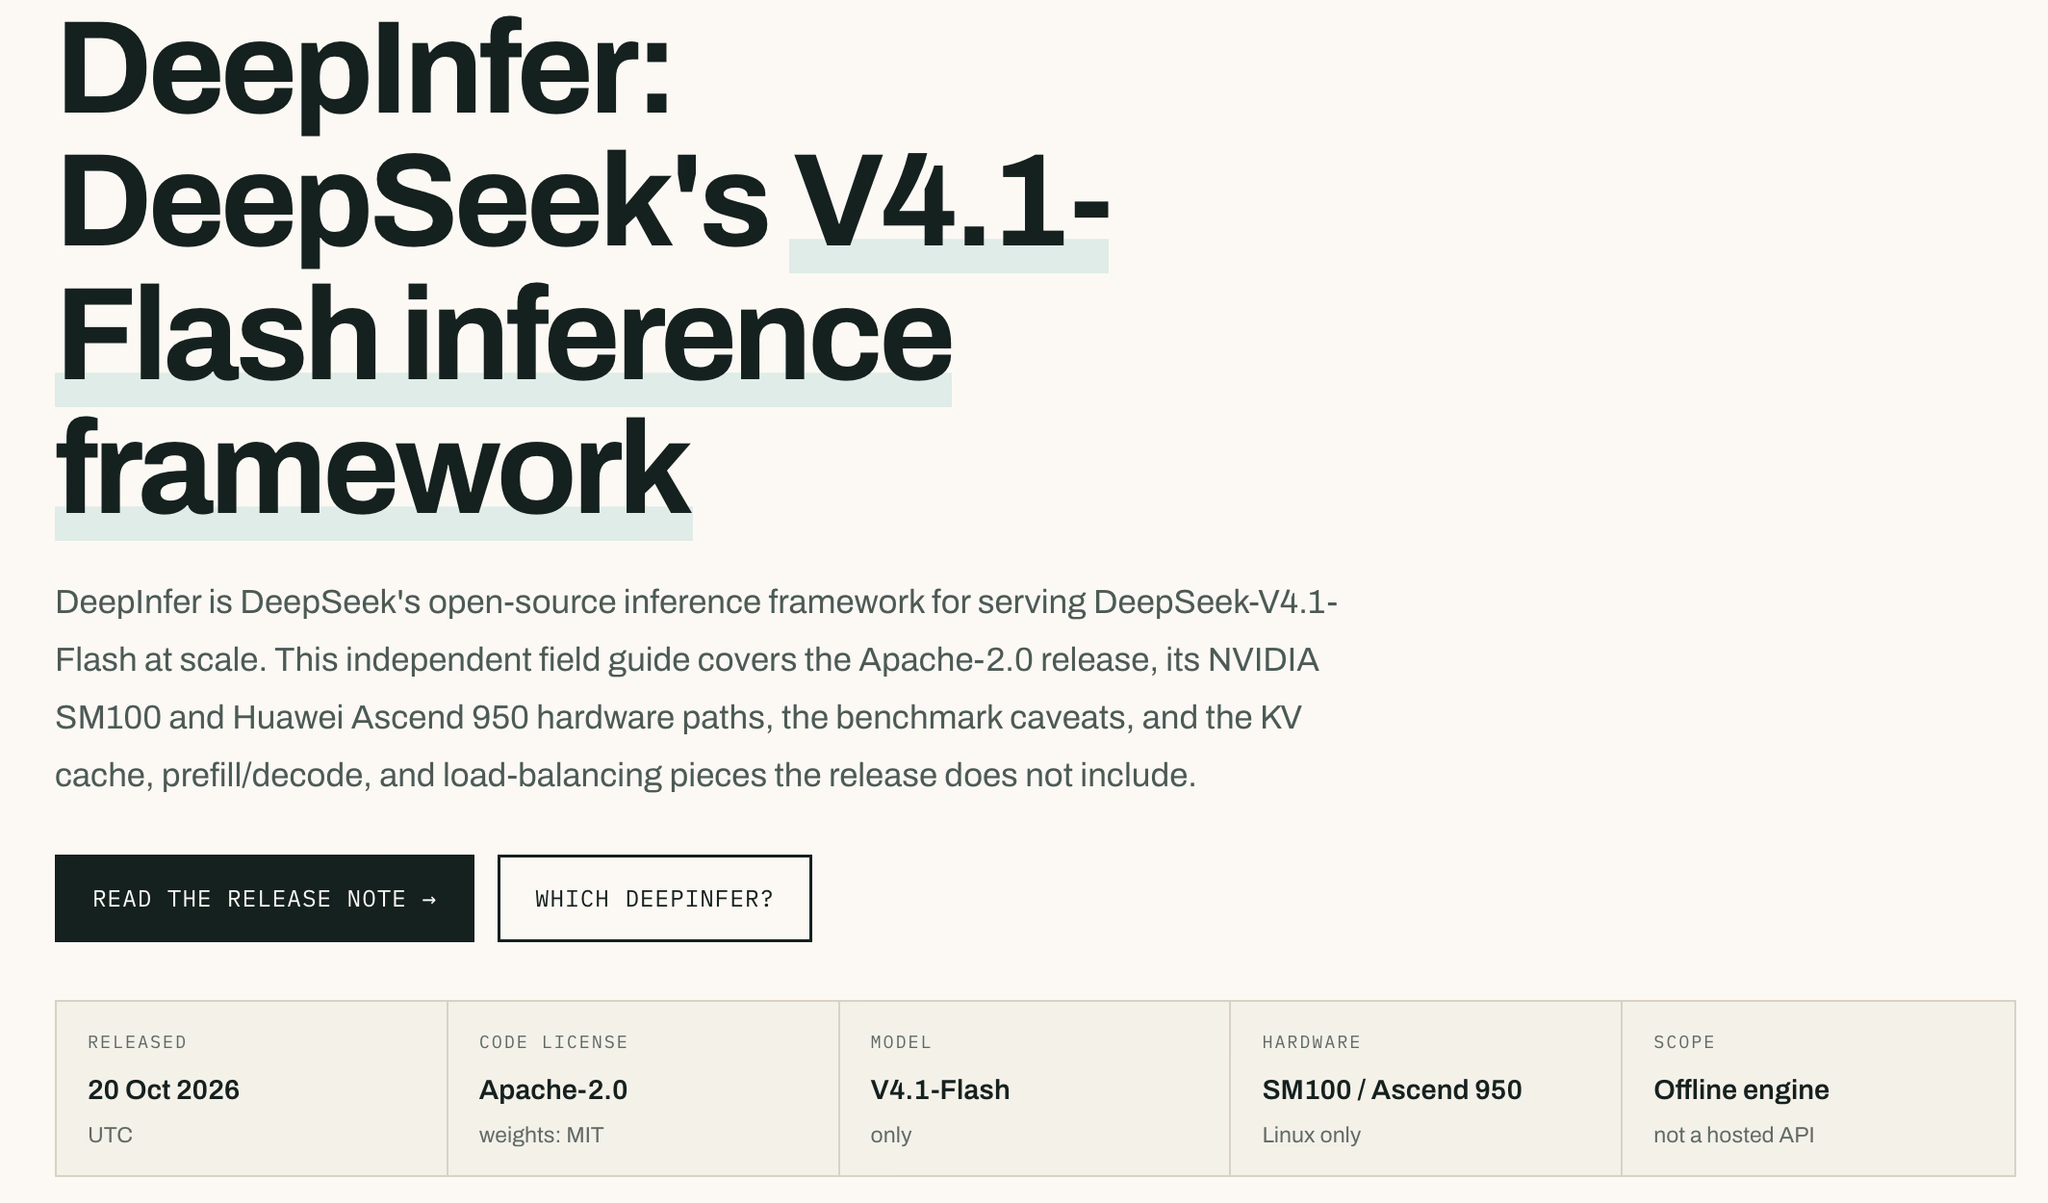
DeepInfer est le framework d'inférence open source de DeepSeek pour servir le modèle DeepSeek-V4.1-Flash à grande échelle. Il réunit des kernels optimisés comme FlashMLA, DeepGEMM et DeepEP au sein d'un moteur unique doté du parallélisme d'experts, du décodage spéculatif et de la récupération de cache à fenêtre glissante.
Un moteur, pas un service.
Cette version inclut des modes déterministes et une ordonnancement asynchrone, mais omet le cache KV, la dissociation prefill/decode et l'équilibrage de charge—laissant ces aspects à la charge de l'utilisateur. Elle prend en charge les chemins matériels NVIDIA SM100 et Huawei Ascend 950.
| Fonctionnalité | Incluse |
|---|---|
| Kernels optimisés | Oui |
| Parallélisme d'experts | Oui |
| Système de cache KV | Non |
Mots-clés du produit
Chargement des commentaires...
Créateur
DeepInfer est le framework d'inférence open source de DeepSeek pour servir le modèle DeepSeek-V4.1-Flash à grande échelle. Il assemble des kernels optimisés jusqu'ici séparés — FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect et des kernels TileLang personnalisés — au sein d'un moteur unique, publié sous licence Apache-2.0. Plutôt qu'un service hébergé, c'est un moteur issu de la production, construit autour du parallélisme d'experts, du décodage spéculatif et de la récupération de cache à fenêtre glissante, avec des chemins matériels pour NVIDIA SM100 et Huawei Ascend 950.
FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect et des kernels TileLang personnalisés sont intégrés dans un seul moteur. Les différents éléments avaient déjà été publiés séparément ; cette version les réunit.
L'attention fonctionne en parallélisme de données tandis que la partie MoE utilise le parallélisme d'experts. Dans la conception de production de DeepSeek, le décodage répartit les experts sur 64 à 128 GPU et rééquilibre les experts sollicités à l'aide de copies redondantes.
Des tokens candidats sont proposés en amont, et une tête de confiance prédit lesquels valent la peine d'être vérifiés. DeepSeek annonce +4 à 7 % de débit à son point de fonctionnement en production.
Au lieu de reconstruire l'intégralité du cache à fenêtre glissante à chaque couche, le moteur ne rejoue que la fin récente. Le résultat est approximatif, mais le coût de recalcul devient borné.
Un moteur, pas un service.
Cette distinction est la chose la plus importante à comprendre à propos de DeepInfer. Un service d'inférence complet nécessite aussi un système de cache KV, une désagrégation prefill/decode et un équilibrage de charge entre les réplicas en parallélisme de données — et aucun des trois n'est inclus. Cet écart est une frontière de conception délibérée plutôt qu'un oubli : DeepSeek a conservé les parties les plus étroitement couplées à son infrastructure interne, ce qui change à la fois qui peut utiliser le code et ce qu'il faut en attendre. L'inférence invariante par lot et l'échantillonnage déterministe sont disponibles sur NVIDIA, ce qui rend les benchmarks et les exécutions d'agents auditables.
Vous voulez observer de près comment DeepSeek sert un modèle open-weight de pointe — un large parallélisme d'experts au décodage, une spéculation planifiée par confiance et une politique de cache qui échange l'exactitude contre un recalcul borné — et vous êtes prêt à fournir vous-même les couches de cache KV, de désagrégation et d'équilibrage de charge. Les idées restent utiles même si vous n'exécutez jamais le code.
D'autres outils que vous pourriez envisager
Découvrez Mellum, une famille de modèles linguistiques rapides, incluant un modèle de nouvelle génération pour une inférence à très faible latence et haute performance.
BeatAPI est une plateforme API unifiée pour les agents IA et les applications que les développeurs créent. Elle réunit plus de 70 modèles d'IA, plus de 1 000 API de données sociales et des outils web via une seule clé API, un seul catalogue de capacités et un seul solde prépayé en USD, ce qui réduit le besoin de gérer des comptes fournisseurs, des intégrations et des factures séparés. MODÈLES, DONNÉES ET OUTILS AU MÊME ENDROIT Accédez à des modèles de texte, d'image et de vidéo ainsi qu'à des données sociales publiques provenant de plateformes telles que TikTok, Instagram, YouTube, X, Reddit et LinkedIn. Récupérez des publications, des profils, des commentaires, des résultats de recherche et des tendances sous forme de données structurées. Les outils web prennent en charge la recherche, la lecture de pages, les plans de site et la recherche documentaire, tandis que les workflows créatifs couvrent des cas d'usage comme les clips musicaux et les vidéos e-commerce. CONÇU POUR LES AGENTS ET LES DÉVELOPPEURS BeatAPI fonctionne avec Claude Code, Codex, Cursor, OpenCode, Muse, ainsi qu'avec des agents ou applications personnalisés compatibles MCP ou requêtes HTTP. Son workflow Search, Inspect, Run permet aux agents de découvrir une capacité, d'examiner son schéma d'entrée, ses sorties, sa tarification et son mode d'exécution, puis de l'exécuter via l'interface Run prise en charge ou son endpoint API documenté. Les développeurs peuvent également intégrer directement via REST et les API compatibles avec les modèles pris en charge. UNE TARIFICATION CLAIRE ET UNE EXÉCUTION TRAÇABLE La tarification est disponible avant tout appel, avec les tarifs des modèles affichés aux côtés des prix publics des fournisseurs et des économies pouvant atteindre 78 % sur certains modèles. Les tâches d'image, de vidéo et de workflow exposent les identifiants de tâche, le statut, l'utilisation, les sorties et les détails d'échec. Les tâches multimédias terminées renvoient des URL de fichiers hébergés, ce qui facilite la livraison des résultats sans avoir à construire un pipeline de stockage séparé. DU PROTOTYPE AU PRODUIT BeatAPI est conçu pour les développeurs indépendants, les startups, les équipes produit et ingénierie, les plateformes SaaS et les créateurs d'automatisations. Utilisez-le pour ajouter de la génération IA à une application, explorer du contenu social public, faciliter la découverte de créateurs, automatiser la recherche web ou donner à un agent l'accès à des modèles et des données sans connecter chaque service séparément. Commencez avec une seule clé, explorez le catalogue, testez un modèle dans le playground et réutilisez la même intégration à mesure que votre produit évolue.
PgDog est un pool de connexions, un répartiteur de charge et un proxy de sharding open source pour PostgreSQL. Il est conforme à Postgres, rapide, sécurisé et développé en toute transparence par une communauté d'ingénieurs en bases de données.
Les applications MCP sont le nouveau site web : ce sont de véritables applications interactives qui s'exécutent directement dans des assistants IA comme ChatGPT et Claude. Les outils pour les construire n'existaient pas, alors nous les avons créés. Découvrez Skybridge, le framework React qui gère l'infrastructure et la boucle de développement pour que vous puissiez vous concentrer sur vos fonctionnalités : serveur MCP, rendu des vues, compatibilité client, tunnel de test, et bien plus encore. Codez une fois, déployez partout. Déjà plus de 500 000 téléchargements et des dizaines d'applications dans les stores !
Chargement des commentaires...