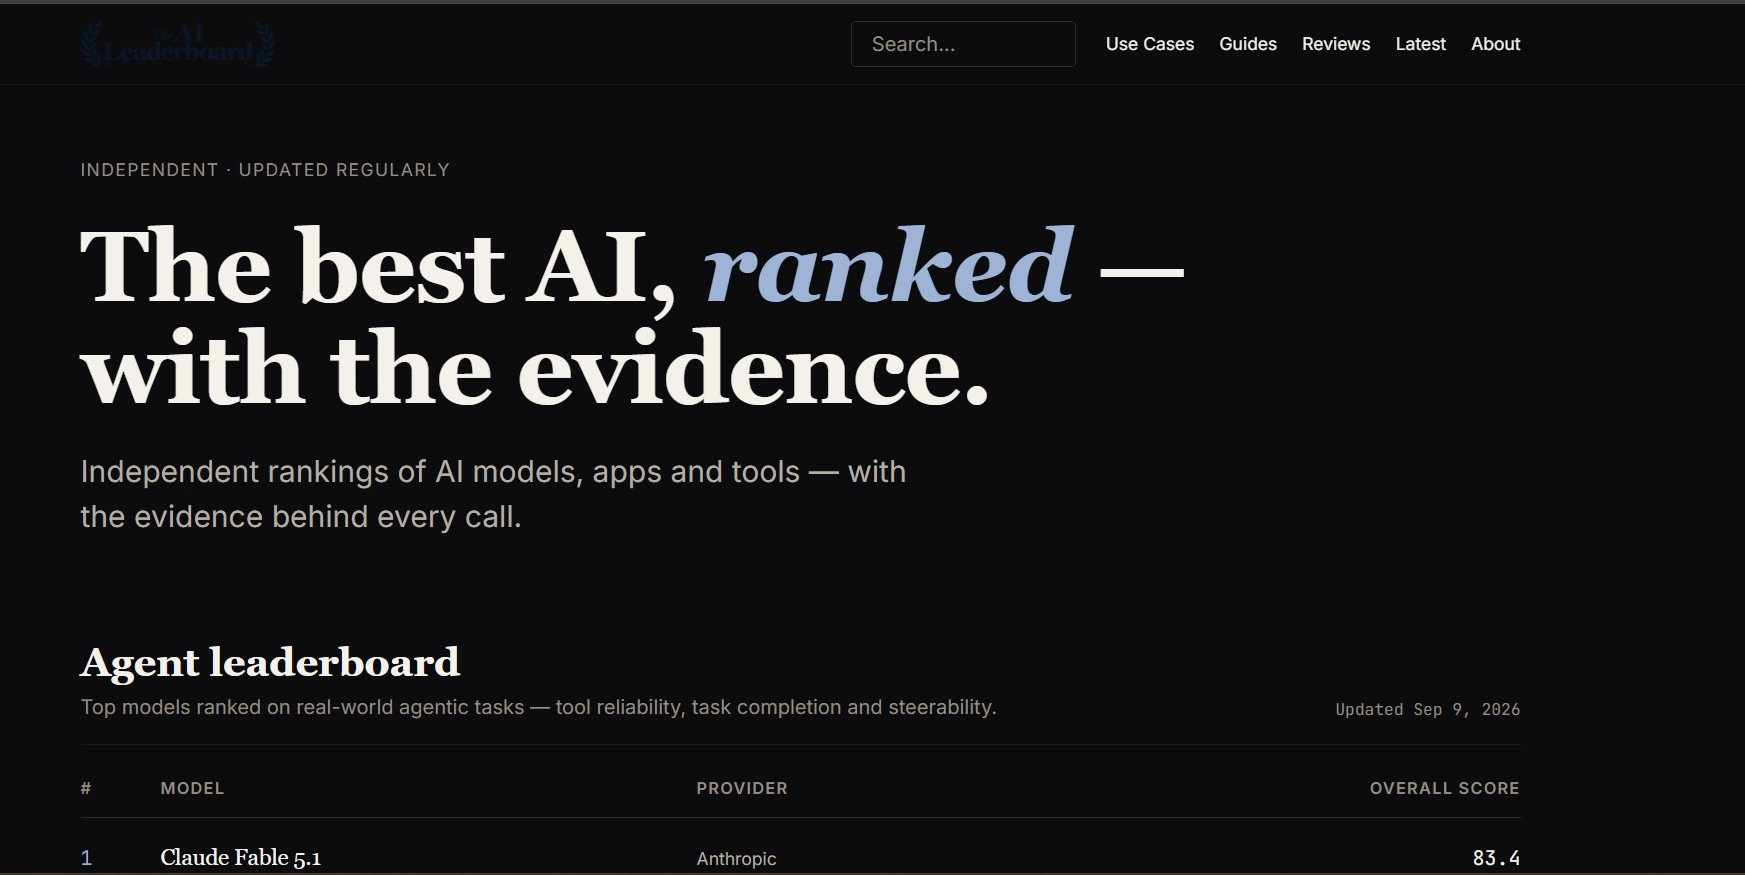
AI 排行榜帮助人们通过当前的基准排名、定价、规格和可用性来比较领先的 AI 模型。它包含详细的模型指南、提供商目录、产品评测、正面对比以及针对特定用例的推荐。AI 排行榜结合了独立基准、同行评审研究和独立评测,每一条结论都附有其证据链接。
加载评论中...

制作者
The AI Leaderboard 是一个独立排名资源,用于比较领先的 AI 模型、应用和工具。它围绕一个简单的承诺定位自身:最好的 AI,经过排名——并附有证据。它不依赖单一分数或单一观点,而是结合可复现的基准测试、同行评审研究和独立评测,并且每个结论都会链接回其支持证据。
这些排名关注的是真实世界能力,而不是实验室演示。例如,其智能体排行榜会根据智能体任务对模型评分——包括工具可靠性、任务完成度和可操控性——收录来自 Anthropic、OpenAI、Meta 和 Moonshot AI 等提供方的专有模型和开放权重模型。除了排名之外,该平台还发布详细的模型指南、提供方目录、产品评测、正面对比以及针对特定用例的推荐。
模型会根据真实世界的智能体任务进行排名,涵盖工具可靠性、任务完成度和可操控性。每个条目都会显示模型、其提供方、它是专有模型还是开放权重模型,以及总体得分。
排名依据可复现的基准测试、同行评审研究和独立评测,而不是单一指标。每个结论都会链接到其背后的证据,因此各种说法可以被核查,而不是只能凭信任接受。
深度指南涵盖单个模型,包含经过验证的规格、定价、访问方式、能力、限制以及实用评估框架。正面对比和用例汇总也一并提供。
一份简短的每日简报,将过去 24 小时的 AI 动态浓缩为大约 90 秒的阅读内容。近期条目涵盖了新模型发布、基础设施投资和监管进展。
我们测试,而不是猜测——并且每个结论都会链接到其证据。
这种动手测试与可追溯来源的结合,是其核心主张。模型会运行相同的受控试验——智能体任务、编程、长上下文推理和工具使用——并在模型变化时重新运行,因此随着新版本发布和基准变化,排名也能保持最新。同样重要的是,该平台声明它不从其所报道的实验室收取费用,当排名会影响采购和采用决策时,这一点尤为重要。
你正在多个 AI 模型之间做选择,并且想要能够追溯到来源、而不是只能凭信任接受的排名。如果你需要关于特定模型的通俗指南,或用于学习、作业和改写的 AI 工具实用对比,它也是一个合理的选择。而且,如果跟上 AI 进展感觉像一份全职工作,那么每日简报提供了一种快速了解最新动态、避开噪音的方式。
加载评论中...
其他您可能感兴趣的工具