Qu'est-ce que The AI Leaderboard ?
The AI Leaderboard est une ressource de classement indépendante pour comparer les principaux modèles, applications et outils d'IA. Elle se positionne autour d'une promesse simple : les meilleurs de l'IA, classés — avec les preuves à l'appui. Plutôt que de s'appuyer sur un score unique ou une opinion unique, elle combine des benchmarks reproductibles, des études évaluées par les pairs et des avis indépendants, et chaque verdict renvoie aux preuves qui le soutiennent.
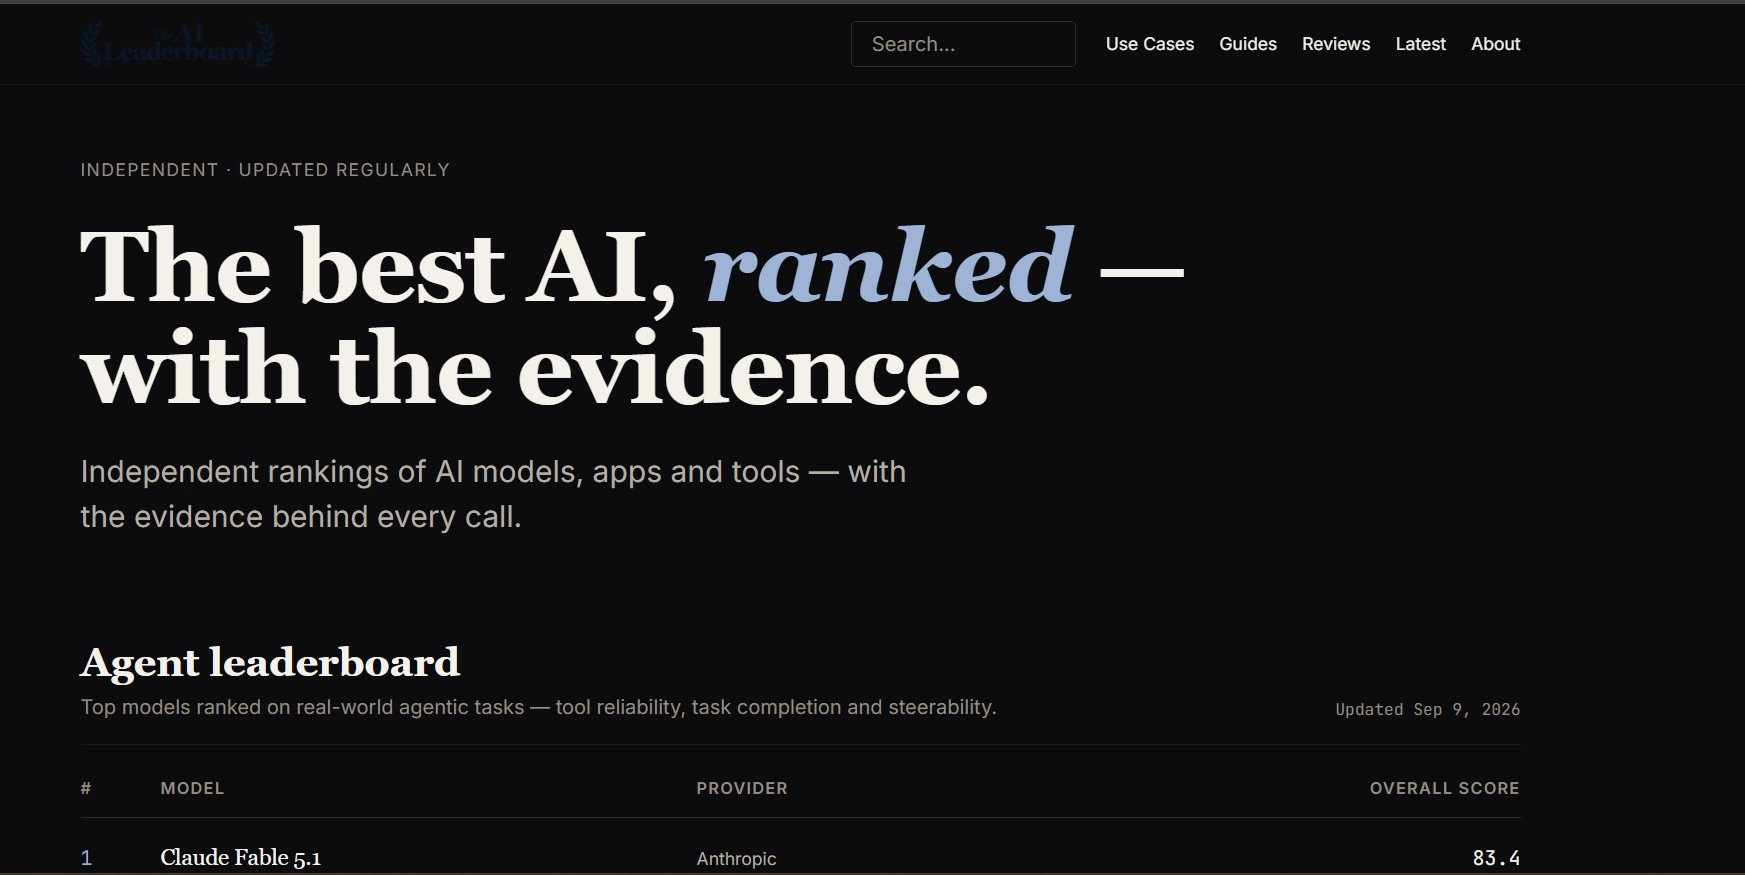
Les classements portent sur les capacités réelles plutôt que sur des démos de laboratoire. Son classement d'agents, par exemple, évalue les modèles sur des tâches agentiques — fiabilité des outils, achèvement des tâches et contrôlabilité — avec des entrées couvrant des modèles propriétaires et à poids ouverts de fournisseurs tels qu'Anthropic, OpenAI, Meta et Moonshot AI. En parallèle des classements, la plateforme publie des guides détaillés sur les modèles, des annuaires de fournisseurs, des avis sur des produits, des comparaisons en face à face et des recommandations pour des cas d'usage spécifiques.
À qui cela s'adresse
- Évaluateurs de modèles et acheteurs techniques — qui ont besoin de classements de benchmarks à jour, de tarifs, de spécifications et de disponibilité avant de s'engager sur un modèle.
- Étudiants et utilisateurs du quotidien — à la recherche de comparaisons pratiques d'outils d'IA pour l'étude, les devoirs, les cartes mémoire et la reformulation.
- Toute personne suivant le marché de l'IA — qui souhaite un résumé quotidien rapide des lancements, de l'actualité des infrastructures et des évolutions réglementaires.
Fonctionnalités clés
Classement d'agents
Les modèles sont classés sur des tâches agentiques réelles, couvrant la fiabilité des outils, l'achèvement des tâches et la contrôlabilité. Chaque entrée indique le modèle, son fournisseur, s'il est propriétaire ou à poids ouverts, et un score global.
Verdicts liés aux preuves
Les classements s'appuient sur des benchmarks reproductibles, des études évaluées par les pairs et des avis indépendants plutôt que sur une seule métrique. Chaque verdict renvoie aux preuves qui le sous-tendent, de sorte que les affirmations peuvent être vérifiées plutôt qu'acceptées sur parole.
Guides et comparaisons de modèles
Des guides approfondis couvrent chaque modèle avec des spécifications vérifiées, les tarifs, l'accès, les capacités, les limites et un cadre d'évaluation pratique. Des comparaisons en face à face et des synthèses par cas d'usage les accompagnent.
AI Daily Signal
Un court briefing quotidien condense les dernières 24 heures de l'IA en environ 90 secondes de lecture. Les éléments récents ont couvert de nouvelles sorties de modèles, des investissements en infrastructures et des évolutions réglementaires.
Ce qui ressort
Nous testons, nous ne devinons pas — et chaque verdict renvoie à ses preuves.
Cette combinaison de tests pratiques et de sources traçables est au cœur de la proposition. Les modèles passent les mêmes essais contrôlés — tâches agentiques, codage, raisonnement sur contexte long et utilisation d'outils — et sont réévalués lorsque les modèles changent, afin que les classements restent à jour au fil des nouvelles versions et de l'évolution des benchmarks. Tout aussi important, la plateforme déclare ne prendre aucun argent des laboratoires qu'elle couvre, ce qui compte lorsque les classements influencent les décisions d'achat et d'adoption.
À découvrir si…
Vous hésitez entre plusieurs modèles d'IA et souhaitez des classements que vous pouvez retracer jusqu'à leurs sources plutôt que d'y croire sur parole. C'est aussi une étape judicieuse si vous avez besoin de guides en langage clair sur des modèles spécifiques, ou de comparaisons pratiques d'outils d'IA pour étudier, faire ses devoirs et reformuler. Et si suivre l'actualité de l'IA vous semble un travail à plein temps, le signal quotidien offre un moyen rapide de rester à jour sans le bruit.