댓글 로딩 중...

제작자
The AI Leaderboard는 주요 AI 모델, 앱, 도구를 비교하기 위한 독립적인 순위 리소스입니다. 이는 "최고의 AI를 근거와 함께 순위로 매긴다"는 단순한 약속을 내세웁니다. 단일 점수나 단일 의견에 의존하는 대신, 재현 가능한 벤치마크, 동료 검토 연구, 독립적인 리뷰를 결합하며, 모든 평가는 이를 뒷받침하는 근거로 연결됩니다.
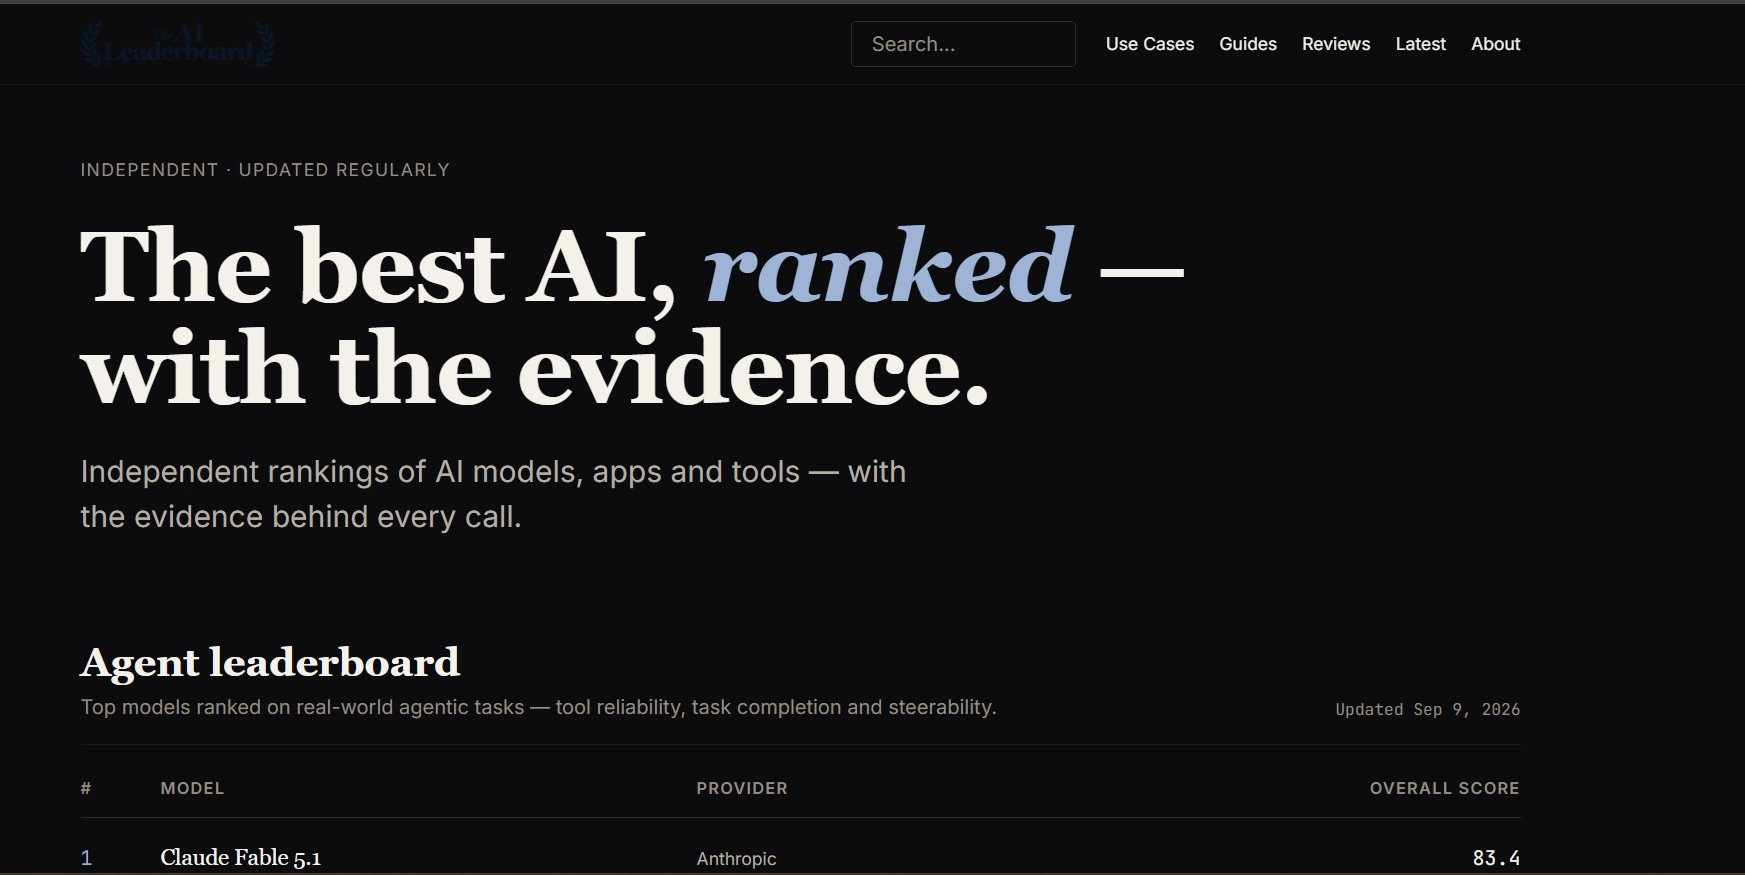
순위는 실험실 데모가 아닌 실제 역량을 다룹니다. 예를 들어 에이전트 리더보드는 도구 신뢰성, 작업 완료, 조종 가능성을 기준으로 모델에 점수를 매기며, Anthropic, OpenAI, Meta, Moonshot AI 같은 제공업체의 독점 모델과 오픈 웨이트 모델을 아우릅니다. 순위와 함께, 이 플랫폼은 상세한 모델 가이드, 제공업체 디렉터리, 제품 리뷰, 일대일 비교, 특정 사용 사례에 대한 추천을 게시합니다.
모델은 도구 신뢰성, 작업 완료, 조종 가능성을 포괄하는 실제 에이전트 작업을 기준으로 순위가 매겨집니다. 각 항목은 모델, 제공업체, 독점인지 오픈 웨이트인지, 그리고 종합 점수를 보여줍니다.
순위는 단일 지표가 아니라 재현 가능한 벤치마크, 동료 검토 연구, 독립적인 리뷰에 기반합니다. 모든 평가는 그 뒤에 있는 근거로 연결되므로, 주장을 그냥 믿는 대신 확인할 수 있습니다.
심층 가이드는 검증된 사양, 가격, 접근성, 기능, 한계, 실용적인 평가 프레임워크와 함께 개별 모델을 다룹니다. 일대일 비교와 사용 사례 모음도 함께 제공됩니다.
짧은 일일 브리핑은 지난 24시간의 AI 소식을 약 90초 분량의 읽을거리로 압축합니다. 최근 항목들은 새 모델 출시, 인프라 투자, 규제 동향을 다뤘습니다.
우리는 추측하지 않고 테스트하며 — 모든 평가는 그 근거로 연결됩니다.
직접 테스트와 추적 가능한 출처의 결합이 이 제안의 핵심입니다. 모델은 동일한 통제된 시험 — 에이전트 작업, 코딩, 장문맥 추론, 도구 사용 — 을 거치며, 모델이 바뀌면 다시 실행되므로 새 버전이 출시되고 벤치마크가 변해도 순위가 최신으로 유지됩니다. 그만큼 중요한 점은, 이 플랫폼이 다루는 연구소로부터 돈을 받지 않는다고 밝힌다는 것입니다. 이는 순위가 구매와 도입 결정에 영향을 미칠 때 중요한 문제입니다.
AI 모델 중에서 선택해야 하고, 그냥 믿기보다 출처까지 추적할 수 있는 순위를 원한다면 유용합니다. 특정 모델에 대한 쉬운 설명 가이드가 필요하거나, 공부, 숙제, 문장 다듬기를 위한 AI 도구를 실용적으로 비교하고 싶을 때도 합리적인 선택입니다. 그리고 AI를 따라가는 것이 마치 전업처럼 느껴진다면, 데일리 시그널은 잡음 없이 빠르게 최신 동향을 파악할 수 있는 방법을 제공합니다.
댓글 로딩 중...
고려해볼 만한 다른 도구